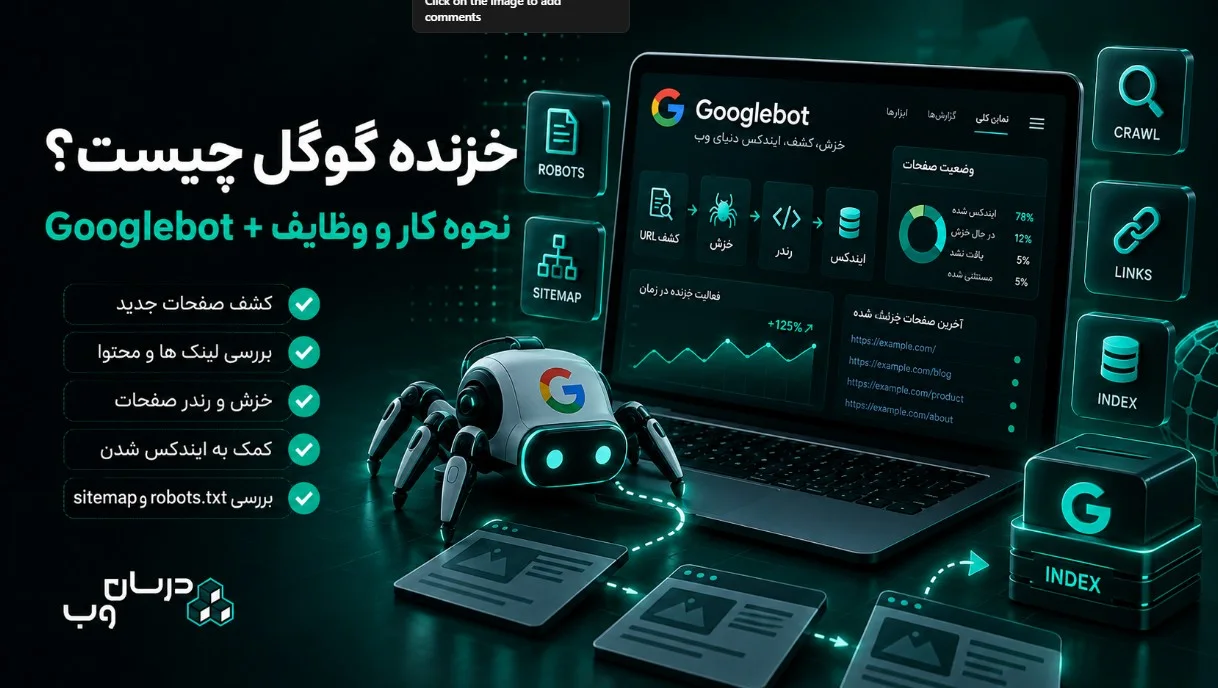
وقتی امروز یک مقاله جدید منتشر می کنید، گوگل همان لحظه از وجود آن خبر ندارد. ابتدا باید URL را کشف کند، سپس Googlebot به آن مراجعه کند و محتوا را دریافت کند، بعد سیستم های گوگل آن را پردازش کنند و در صورت مناسب بودن، امکان ورود صفحه به ایندکس فراهم شود.
این مقاله دقیقا همین سفر را از لحظه انتشار یک صفحه تا زمانی که ممکن است در Google Search ظاهر شود، توضیح می دهد. با خواندن این راهنما یاد می گیرید خزنده گوگل چیست، Googlebot چگونه کار می کند، و چرا گاهی صفحه شما Crawl می شود ولی Index نمی شود.
خزنده یا Crawler چیست؟
در دنیای وب، اصطلاحات Crawler، Bot و Spider تقریبا به یک معنا استفاده می شوند: نرم افزارهای خودکاری که صفحات وب را پیدا و دریافت می کنند.
طبق مستندات رسمی گوگل، کراولر یا خزنده رباتی است که به صورت خودکار وب سایت شما را پیدا خواهد کرد و در نهایت آن را بررسی می کند. گوگل چندین نوع خزنده یا کراولر دارد .
یک مثال ساده از نحوه حرکت خزنده:
صفحه A → لینک → صفحه B → لینک → صفحه C
ربات گوگل وارد صفحه A می شود، لینک صفحه B را پیدا می کند و در ادامه ممکن است صفحه C را نیز کشف کند.
Googlebot چیست؟
گوگل بات خزنده اصلی نتایج جستجو گوگل است. اما نکته مهم این است که ربات گوگل را با کل سیستم گوگل یکی نکنیم.
Googlebot صفحه را Crawl می کند؛ اما Crawl شدن یک صفحه به این معنی نیست که حتما Index شود یا رتبه بگیرد.
گوگل نیز Googlebot را به عنوان خزنده ای معرفی می کند که برای یافتن اطلاعات مورد نیاز Search و محصولات وابسته استفاده می شود. این ربات صفحات وب را کشف می کند، محتوای آن ها را دریافت می کند و سپس سیستم های گوگل درباره نحوه استفاده از آن محتوا تصمیم می گیرند.
گوگل چگونه یک صفحه اینترنتی را پیدا می کند؟
فرآیند پیدا کردن و نمایش یک صفحه در گوگل از چند مرحله تشکیل شده است:
Discovery → Crawling → Processing/Rendering → Indexing → Serving/Ranking
مرحله اول؛ کشف URL
گوگل می تواند صفحه را از طریق موارد زیر پیدا کند:
- لینک های داخلی
- لینک سایت های دیگر
- Sitemap
- URLهایی که قبلا می شناخته
مرحله دوم؛ Crawling
Googlebot درخواست HTTP برای URL ارسال می کند و اطلاعات صفحه را دریافت می کند.
مرحله سوم؛ پردازش و Rendering
HTML، لینک ها، منابع و در صورت نیاز محتوای تولیدشده توسط JavaScript پردازش می شوند.
مرحله چهارم؛ Indexing
اینجاست که گوگل تصمیم می گیرد محتوا را در سیستم ایندکس خود پردازش و نگهداری کند یا نه.
مرحله پنجم؛ نمایش و رتبه بندی
تنها بعد از آن است که صفحه امکان حضور در نتایج جستجو برای Queryهای مرتبط را پیدا می کند.
تفاوت Crawl، Index و Ranking چیست؟
| مرحله | معنی |
|---|---|
| Discovery | گوگل URL را پیدا می کند |
| Crawling | Googlebot به URL مراجعه و اطلاعات آن را دریافت می کند |
| Indexing | گوگل صفحه و محتوای آن را پردازش می کند |
| Ranking | سیستم های گوگل مشخص می کنند صفحه برای یک جستجو در چه جایگاهی نمایش داده شود |
Crawl شدن ≠ Index شدن ≠ رتبه گرفتن
Googlebot چگونه از صفحه ای به صفحه دیگر می رسد؟
ربات گوگل عمدتاً از طریق لینک ها از صفحه ای به صفحه دیگر می رود. ساختار لینک سازی داخلی نقش کلیدی در کشف صفحات دارد.
مثال:
صفحه اصلی ↓ دسته بندی سئو ↓ آموزش سئو ↓ خزنده گوگل
اگر یک صفحه هیچ لینک داخلی نداشته باشد، کشف آن می تواند دشوارتر شود. به این صفحات، صفحات یتیم می گویند.
نقشه سایت چه کمکی به خزنده گوگل می کند؟
نقشه سایت به گوگل در کشف آدرس های جدید از سایت شما کمک می کند، اما پیدا کردن نقشه سایت و بررسی آن توسط خزنده گوگل تضمینی برای ایندکس شدن و به نمایش در آمدن اون صفحه در نتایج جستجو گوگل نیست.
نباید تصور کرد: «اگر صفحات ما در بخش نقشه سایت قرار گرفته گوگل حتما صفحات را ایندکس می کند.» این درست نیست. نقشه سایت یا Sitemap فقط مسیر را نشان می دهد، اما تصمیم نهایی برای ایندکس شدن و به نمایش در آمدن آن صفحه برای مخاطبان با الگوریتم های گوگل است.
robots.txt چیست و چه ارتباطی با ربات گوگل دارد؟
robots.txt فایلی است که به خزنده های موتور جستجو می گوید کدام مسیرها را خزش کند یا کدام صفحات را خزش نکند.
مثال ساده:
User-agent: Googlebot Disallow: /private/
این دستور می گوید ربات گوگل مسیر /private/ را کراول نکند. گوگل می گوید خزنده های عمومی آن در Crawl خودکار قواعد robots.txt را رعایت می کنند.
robots.txt با noindex یکی نیست.
حتی ممکن است URLای که با robots.txt بلاک شده، از طریق لینک های دیگر شناخته شود و URL آن بدون محتوای صفحه در نتایج دیده شود. خود گوگل صراحتا به این نکته اشاره می کند.
گوگل چه خزنده هایی دارد؟
طبق مستندات جدید گوگل، کلاینت های خزنده گوگل اساساً در سه گروه قرار می گیرند:
- Common Crawlers: خزنده های عمومی مثل Googlebot که برای Search و محصولات مختلف استفاده می شوند.
- Special-case Crawlers: برای محصولات یا شرایط خاص، مانند برخی crawlerهای تبلیغاتی.
- User-triggered Fetchers: زمانی که یک کاربر در یک محصول گوگل باعث Fetch شدن یک URL می شود.
معروف ترین خزنده های گوگل:
| خزنده | کاربرد |
|---|---|
| Googlebot | جستجوی عمومی گوگل |
| Googlebot-Image | تصاویر |
| Googlebot-Video | ویدیو |
| Googlebot-News | Google News |
| Storebot-Google | Google Shopping |
گوگل برای این crawlerها User-agentهای جداگانه نیز مستند کرده است.
Googlebot Smartphone و Desktop چه هستند؟
Googlebot می تواند با User-Agent موبایل یا دسکتاپ درخواست ارسال کند. اما آن ها را دو موتور جستجوی مستقل معرفی نکنیم؛ هر دو شکل هایی از Googlebot هستند.
نمونه User Agent:
Googlebot/2.1
User-Agent چیست؟
User-Agent بخشی از درخواست HTTP است که مشخص می کند درخواست از طرف چه نرم افزاری ارسال شده است. وقتی Googlebot به سایت شما مراجعه می کند، چیزی شبیه به این همراه درخواست است:
Googlebot/2.1
فقط اینکه یک درخواست نام Googlebot داشته باشد ثابت نمی کند واقعا متعلق به گوگل است.
User-Agent قابل جعل است. گوگل برای تایید crawler واقعی توصیه می کند IP و Reverse DNS نیز بررسی شود و برای crawlerهایش IP range رسمی منتشر می کند.
Crawl Budget چیست؟
گوگل منابع نامحدود برای Crawl هر URL در هر لحظه ندارد. به این محدودیت، Crawl Budget می گویند.
برای سایت های خیلی بزرگ مثلا:
- فروشگاه با ۵۰۰ هزار URL
- فیلترهای متعدد
- صفحات پارامتردار
- URLهای تکراری
موضوع Crawl Budget جدی تر می شود. برای یک سایت ۳۰ صفحه ای لازم نیست صاحب سایت وسواس Crawl Budget داشته باشد.
چه چیزهایی باعث هدر رفت Crawl می شوند؟
- URLهای فیلتر بی نهایت
- پارامترهای غیرضروری
- صفحات Duplicate
- Redirect chain
- صفحات 404 زیاد
- تقویم های بی نهایت
- Faceted Navigation بد
- ساختار لینک داخلی ضعیف
سرعت سرور چه تاثیری روی خزنده گوگل دارد؟
گوگل می گوید تلاش می کند تا حد امکان سایت را Crawl کند بدون اینکه سرور را تحت فشار قرار دهد. بنابراین توان پاسخگویی سرور می تواند روی نحوه Crawl شدن سایت اثر بگذارد.
مواردی مثل:
- TTFB بالا
- Timeout
- خطای 5xx
- محدودیت شدید Firewall
- Rate Limit نامناسب
می توانند دردسر ایجاد کنند.
آیا Googlebot تصاویر و ویدیوها را هم می بیند؟
بله، گوگل برای Images و Video خزنده های مشخصی دارد:
- Googlebot-Image
- Googlebot-Video
حتی می توان قواعد مربوط به آن ها را جداگانه در robots.txt تنظیم کرد.
چگونه بفهمیم Googlebot وارد سایت شده است؟
سه روش اصلی:
- Google Search Console: بخش URL Inspection، Page Indexing و Crawl Stats
- Server Logs: بررسی درخواست هایی با Googlebot User-Agent
- تایید IP/DNS: برای اطمینان از اینکه Googlebot جعلی نیست
چرا گوگل صفحه من را Crawl نمی کند؟
سناریوهای رایج:
- robots.txt مانع شده
- لینک داخلی ندارد
- صفحه تازه ساخته شده
- Sitemap مشکل دارد
- URL خطای 404/5xx می دهد
- Redirect اشتباه است
- Server کند یا غیرقابل دسترس است
- ساختار سایت خیلی عمیق است
- URLهای بسیار زیادی تولید شده اند
چرا صفحه Crawl شده ولی Index نشده است؟
Crawl شدن تضمین Index شدن نیست. دلایل احتمالی:
- Duplicate content
- Canonical
- محتوای کم ارزش
- Soft 404
- صفحات بسیار مشابه
- noindex
در مورد Canonical، گوگل ممکن است چند صفحه مشابه را یک گروه در نظر بگیرد و یک URL را به عنوان نسخه Canonical انتخاب کند؛ نسخه های تکراری نیز معمولا کمتر Crawl می شوند.
هر چند وقت یک بار Googlebot به سایت سر می زند؟
زمان ثابتی وجود ندارد. میزان مراجعه با توجه به سایت، URL، تغییرات، اهمیت و شرایط Crawl متفاوت است.
آیا انتشار روزانه محتوا باعث می شود Googlebot هر روز سایت را Crawl کند؟
پاسخ: الزاما نه.
چگونه سایت را برای Crawl بهتر بهینه کنیم؟
چک لیست اجرایی:
- ساختار لینک داخلی منطقی
- Sitemap سالم
- robots.txt صحیح
- Canonical صحیح
- رفع لینک شکسته
- کاهش URLهای بی ارزش
- سرور سریع و پایدار
- استفاده صحیح از Status Code
- کنترل JavaScript
- بررسی Search Console
- بررسی Server Log
جمع بندی
در این مقاله بررسی کردیم که خزنده گوگل چیست، Googlebot چگونه کار می کند و چه مراحلی از کشف URL تا Crawl، Rendering، Indexing و Ranking طی می شود. یاد گرفتیم که Crawl شدن به معنای Index شدن نیست و عوامل متعددی مثل robots.txt، Sitemap، ساختار لینک داخلی، سرعت سرور و Crawl Budget بر نحوه خزیدن گوگل تاثیر می گذارند.
اگر می خواهید سایت شما بهتر Crawl و Index شود، از چک لیست انتهای مقاله استفاده کنید و به طور منظم Search Console و Server Logها را بررسی کنید. به یاد داشته باشید که سئو تکنیکال پایه دیده شدن در گوگل و حتی پاسخ های هوش مصنوعی است.